Per insegnare a un robot a riconoscere le erbe infestanti servono migliaia di fotografie in cui ogni singola pianta è stata etichettata, manualmente, da un esperto in grado di distinguere le specie. È un lavoro lungo e poco riutilizzabile: spesso deve essere ripetuto per ogni nuovo campo e per ogni nuova stagione. Per questo si sta diffondendo l’uso dell’intelligenza artificiale per generare parte delle immagini, e con essa la domanda su quanto debbano essere realistiche per risultare utili. L’aspettativa comune è che immagini sintetiche più realistiche permettano di addestrare rilevatori più accurati. I risultati ottenuti, però, indicano che il realismo non è necessario.
L’argomento è stato affrontato nell’ambito del progetto NeutraWeed, incentrato sul riconoscimento e la gestione selettiva delle erbe spontanee presenti nelle colture (ne abbiamo parlato qui), durante un periodo di ricerca che si è svolto presso il Centro de Automática y Robótica del CSIC di Madrid. NeutraWeed si sviluppa a partire dall’osservazione che non tutte le erbe spontanee danneggiano la coltura e che alcune possono convivere con essa. Prima di concentrarsi sulle piante da rimuovere, però, il robot deve essere in grado di riconoscerle.
Due modi di generare un’immagine
Quando si usano immagini sintetiche per addestrare un rilevatore, la prima domanda sembra quasi inevitabile: quanto devono assomigliare a fotografie reali? Ma il realismo visivo è solo una parte del problema: conta anche quante situazioni diverse le immagini riescono a rappresentare.
Le reti generative avversarie (GAN) mettono in competizione due reti: un generatore, che produce immagini, e un discriminatore, che cerca di distinguere quelle generate dalle immagini reali. Durante l’addestramento, il generatore impara così a produrre immagini sempre più convincenti. Questo meccanismo, però, non garantisce che venga riprodotta tutta la varietà presente nei dati. Il generatore può imparare a produrre molto bene alcune configurazioni, continuando però a trascurarne altre: è il fenomeno noto come collasso delle modalità.
I modelli di diffusione, fra cui Stable Diffusion, vengono addestrati secondo un principio diverso. A partire da immagini progressivamente corrotte dal rumore, imparano a ricostruire l’informazione necessaria per risalire verso l’immagine originale. Non c’è quindi un discriminatore incaricato di stabilire se il risultato sembri reale: il modello impara direttamente dagli esempi utilizzati durante l’addestramento. Anche le configurazioni meno frequenti contribuiscono così al processo di apprendimento.
Questo non significa che un modello di diffusione riproduca automaticamente tutta la distribuzione dei dati, né che sia immune da distorsioni. Il punto è che realismo e varietà non sono la stessa cosa. Un’immagine può sembrare perfettamente realistica senza insegnare nulla di nuovo al rilevatore. Al contrario, un’immagine meno convincente dal punto di vista fotografico può mostrargli una situazione che non aveva ancora incontrato.
Cosa serve al rilevatore
La distinzione è importante perché generatore e rilevatore hanno obiettivi diversi: il primo deve produrre immagini convincenti, il secondo deve imparare a distinguere correttamente le specie.
Parlando di piante, durante l’addestramento, il rilevatore costruisce una separazione fra le specie a partire dalle caratteristiche presenti nelle immagini. Per imparare a riconoscerle, ha bisogno soprattutto di vedere le specie nelle molte condizioni in cui potranno presentarsi sul campo: piante piccole e grandi, illuminate direttamente o in ombra, isolate oppure parzialmente nascoste da altre foglie, fotografate su terreni diversi. Rendere un’immagine più realistica può significare perfezionare un esempio che il modello ha già visto. Aumentare la varietà delle scene, invece, può esporre il modello a nuove combinazioni di forma, posizione, illuminazione, occlusione e contesto. Per il rilevatore, quindi, un’immagine più verosimile e un’immagine che aggiunge qualcosa di nuovo non hanno necessariamente lo stesso valore.
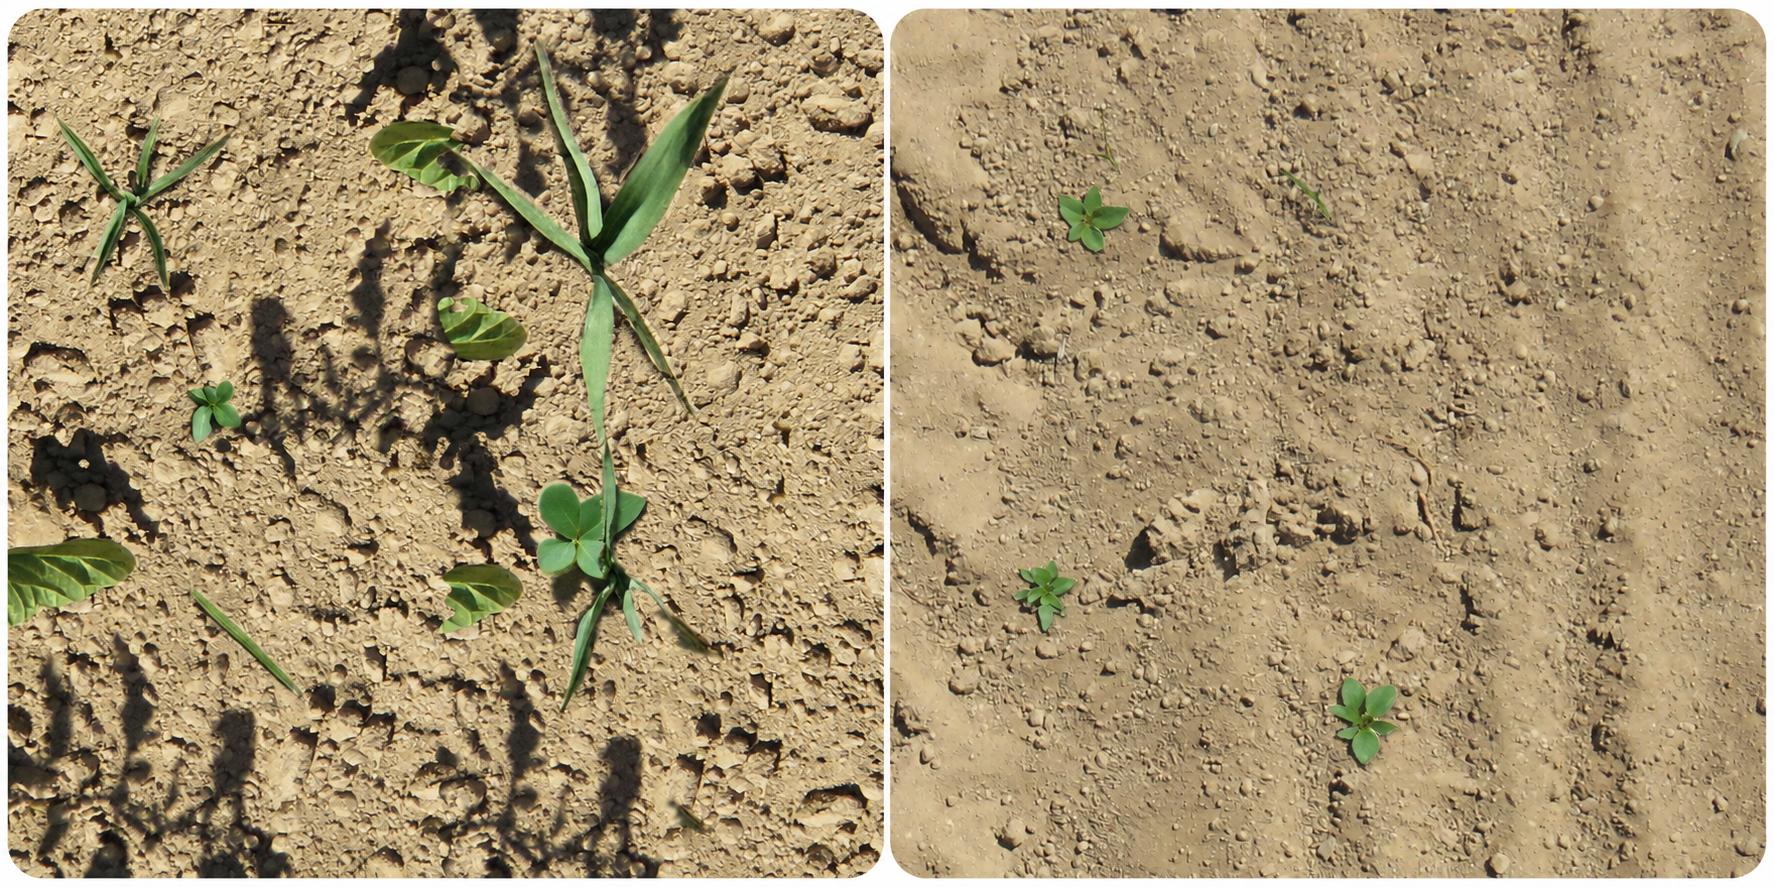
Realismo visivo e utilità per il rilevatore non coincidono necessariamente. A destra, un esempio dal dataset più fotorealistico; a sinistra, un esempio dal dataset meno fotorealistico, che ha portato a un maggiore incremento dell’accuratezza del rilevatore.
Lo stesso vale per la precisione botanica delle immagini sintetiche. Un botanico riconosce una specie attraverso caratteri molto specifici, come nervature, portamento o ordine di emissione delle foglie. Un rilevatore automatico, invece, non “guarda” necessariamente la pianta nello stesso modo: sfrutta le combinazioni di forma, colore e disposizione che gli permettono di distinguere le specie alla risoluzione delle immagini su cui viene addestrato.
Questo non significa che l’accuratezza botanica sia irrilevante: quando il generatore non era stato adattato adeguatamente alle specie considerate, le immagini sintetiche hanno peggiorato le prestazioni del rilevatore. Una volta rappresentati i caratteri necessari a distinguere una specie dall’altra, però, una maggiore fedeltà dei dettagli botanici non ha portato benefici paragonabili a quelli ottenuti aumentando la varietà delle scene.
I risultati
Per esplorare il rapporto tra il realismo delle immagini sintetiche e la loro utilità per l’addestramento, sono state confrontate diverse varianti della pipeline di generazione, ciascuna progettata per intervenire su specifiche proprietà visive. I risultati mostrano che, nel nostro esperimento, aumentare la varietà delle scene è stato più utile che aumentarne soltanto il fotorealismo.
Il risultato ha anche una conseguenza pratica: se aumentare il fotorealismo richiede più risorse computazionali, potrebbe essere più efficace impiegarle per generare un insieme di scene più vario. Nel caso del riconoscimento delle piante in campo, le tecniche adottate si sono rivelate particolarmente utili, perché il riconoscimento delle specie si basa soprattutto su caratteristiche come la forma e la disposizione delle foglie. La domanda, quindi, non è soltanto quanto un’immagine sintetica sembri reale, ma quanto contribuisca ad ampliare ciò che il modello può imparare.
Stay tuned!